

A tempos que eu tenho participado e leio sobre projetos de internalização do conhecimento organizacional para uso em diversas areas que envolve AI, todos claro utilizam o RAG como base e fazem várias alternativas para conseguir melhorar a assertividade das respostas ou até mesmo a velocidade das respostas, ficam gastando horas em chunks, mudando LLM de embedding, estratégias melhores de retrievel, mas basta pesquisar um pouco mais sobre os fundamentos (olha ele aqui de novo) que você percebe que só semântica não vai resolver, por mais que você tenha LLM-as-Judge, Top_k, Top_p, Top dos tops, sério não adianta.
Uma maneira mais precisa seria uma RAG hibrida utilizando o famoso e antigo BM25 para buscar palavras chaves + busca semântica, mas quando estamos falando de um grande volume de dados a coisa começa a ficar cara e demorada. Por isso depois de passar 2 semanas + case de uso + curso da DataCamp eu resolvi escrever esse artigo sobre o GraphRAG e neo4j, se eu soube-se da existencia como eu sei deles hoje, sério, muito projeto que participei teria ganhando uma velocidade absurda.
Teoria dos grafos: Fundamentos
A teoria dos grafos é um ramo da matemática que estuda as relações entre objetos de um conjunto. Ela é representada por estruturas chamadas grafos, denotados como G(V,E)G(V, E)G(V,E), onde:
- VVV é um conjunto não vazio de vértices (ou nós);
- EEE é um conjunto de arestas (ou edges), que são pares de vértices representando conexões.
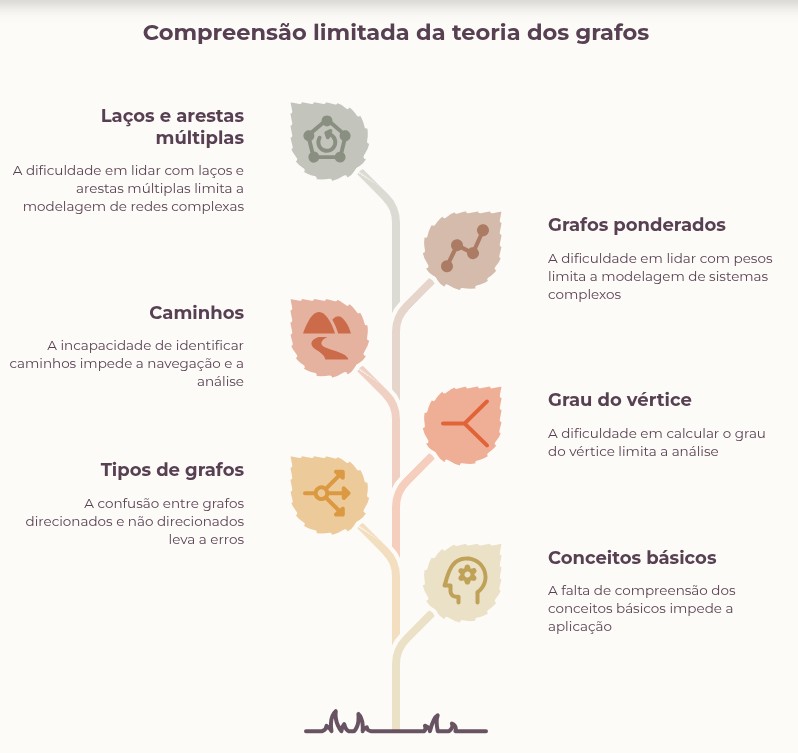
Conceitos básicos:
- Grafo não direcionado: as arestas não têm direção; a conexão entre dois vértices é bidirecional.
- Grafo direcionado (dígrafo): as arestas têm direção, indicadas por setas (origem → destino).
- Grau de um vértice: número de arestas incidentes a ele.
- Caminho: sequência de vértices conectados por arestas.
- Grafo ponderado: arestas ou vértices possuem pesos (valores numéricos).
- Laço: aresta que conecta um vértice a si mesmo.
- Arestas múltiplas: mais de uma aresta entre o mesmo par de vértices.
Esses conceitos formam a base para modelar redes sociais, rotas, dependências, fluxos e qualquer sistema onde relações são tão importantes quanto os próprios elementos.
Neo4j: Origem, Propósito e Funcionamento
Como surgiu?
O Neo4j nasceu de uma necessidade prática: em 2000, os fundadores enfrentavam problemas de desempenho com bancos relacionais (RDBMS) ao executar consultas complexas em um sistema de gerenciamento de conteúdo (CMS). As consultas SQL eram difíceis de manter e lentas.
- 2002: primeiro protótipo desenvolvido.
- 2003: primeira implantação em produção 24×7.
- 2007: projeto open-source lançado sob GPL; fundação da empresa na Suécia.
- 2010: lançamento da versão 1.0.
O Neo4j foi criado como alternativa aos bancos tabulares para cenários onde relações entre dados são centrais.
Para que serve
Neo4j é um banco de dados orientado a grafos nativo, implementado em Java, que armazena dados estruturados como grafos em vez de tabelas. Ele é totalmente transacional e otimizado para consultas que exploram conexões profundas entre entidades.neo4j+2
Diferente de bancos relacionais, onde relações são inferidas via JOIN, no Neo4j as relações são armazenadas explicitamente como arestas, tornando traversals (navegações) extremamente rápidos.
Vantagens do Neo4j
- Desempenho em consultas relacionais profundas: ideal para análises com 3+ níveis de profundidade.
- Modelagem intuitiva: reflete diretamente a estrutura do domínio (nós = entidades, arestas = relações).
- Flexibilidade de esquema: fácil evolução do modelo sem migrações complexas.
- Cypher: linguagem declarativa otimizada para grafos (similar a SQL, mas para padrões de grafos).
- Casos de uso fortes: detecção de fraude, recomendação, gestão de redes, knowledge graphs.
GraphRAG: Conceito e Funcionamento
O que é
GraphRAG (Graph-based Retrieval-Augmented Generation) é uma evolução do RAG tradicional que incorpora grafos de conhecimento ao processo de recuperação e geração de respostas por LLMs
Enquanto o RAG clássico recupera chunks de texto baseados em similaridade vetorial, o GraphRAG:
- Extrai entidades e relações de documentos usando LLMs e NER (Named Entity Recognition).
- Constrói um grafo de conhecimento estruturado (nós = entidades, arestas = relações).
- Durante a consulta, navega pelo grafo para recuperar subgrafos contextualizados, não apenas trechos isolados.
- Enriquece o prompt do LLM com esse contexto estrutural, gerando respostas mais precisas e explicáveis.
Arquitetura típica (3 camadas)
- Camada estrutural: grafo de conhecimento com entidades e relações extraídas.
- Camada vetorial: embeddings em nós e documentos, enriquecidos pelo contexto estrutural.
- Camada híbrida de retrieval: combina traversal no grafo + busca vetorial para recuperar subgrafos + chunks relevantes. (eu particularmente acho a melhor.)
Vantagens e Desvantagens do GraphRAG
Vantagens
- Maior precisão: estudos indicam até 3× mais precisão vs. RAG puramente vetorial em queries complexas.
- Respostas mais completas: o grafo permite conectar informações dispersas em múltiplos documentos.
- Explicabilidade e governança: é possível rastrear quais entidades e relações levaram à resposta, crucial para setores regulados (saúde, finanças, jurídico).
- Descoberta de relações não-óbvias: algoritmos de community detection e análise de subgrafos revelam padrões ocultos.
- Manutenção mais fácil: grafos são mais intuitivos para depurar e iterar do que vetores puros.
Desvantagens e desafios
- Complexidade de implementação: exige pipeline de extração de entidades, construção do grafo e integração com LLMs.
- Custo computacional: processamento inicial para construir o grafo é mais pesado que indexação vetorial simples.
- Dependência de qualidade da extração: se o NER/extração de relações falhar, o grafo fica ruidoso e prejudica o retrieval.
- Menos maturidade: ferramentas e padrões ainda estão em evolução comparado ao RAG vetorial.
Casos de Uso e Aplicações de GraphRAG
Setores e aplicações
- Saúde e pesquisa clínica: conectar sintomas, doenças, proteínas e compostos para acelerar descoberta de medicamentos e sumarização de vias de doenças.
- Detecção de fraude financeira: rastrear redes de empresas de fachada e transações suspeitas que modelos tradicionais não capturam.
- Jurídico e compliance: analisar contratos, processos e entidades relacionadas para due diligence e auditoria.
- Manufatura e supply chain: mapear dependências entre fornecedores, componentes e riscos de interrupção.
Projetos e iniciativas famosas
- Microsoft GraphRAG: projeto open-source no GitHub que fornece pipeline completo para extrair grafos de textos e integrar com LLMs. É a referência principal em GraphRAG hoje.
- Google Cloud (Spanner + GraphRAG): arquitetura documentada para implementar GraphRAG em escala enterprise, com exemplos em saúde, finanças e jurídico/
- Ultralytics e outros: documentação de casos em detecção de defeitos, gestão de inventário e processamento de documentos.
Exemplos de consultar em Cypher no Neo4j:
1. Criando Dados (CREATE / MERGE)
Criar nós simples
CREATE (p:Person {name: 'Alice', age: 30, city: 'São Paulo'})
CREATE (p2:Person {name: 'Bob', age: 25, city: 'Rio de Janeiro'})
Criar relacionamento entre nós
MATCH (a:Person {name: 'Alice'})
MATCH (b:Person {name: 'Bob'})
CREATE (a)-[:KNOWS {since: 2020}]->(b)
Criar com MERGE (evita duplicatas)
MERGE (p:Person {name: 'Carlos'})
ON CREATE SET p.age = 28, p.city = 'Belo Horizonte'
ON MATCH SET p.lastSeen = datetime()
RETURN p
Filtrar com WHERE
MATCH (p:Person)
WHERE p.age > 25 AND p.city = 'São Paulo'
RETURN p.name, p.age
Caminho de comprimento fixo
MATCH (p:Person)-[:KNOWS]->(f:Person)-[:KNOWS]->(ff:Person)
WHERE p.name = 'Alice'
RETURN f.name AS amigoDireto, ff.name AS amigoDoAmigo
Caminho de comprimento variável
MATCH (p:Person {name: 'Alice'})-[:KNOWS*1..3]->(alguem:Person)
RETURN DISTINCT alguem.name AS redeDeContatos
*1..3 significa de 1 a 3 níveis de profundidade.
Integração com busca vetorial (Neo4j + embeddings)
MATCH (d:Document)
SEARCH d IN (
  VECTOR INDEX doc_embeddings
  FOR $queryEmbedding
  LIMIT 10
) SCORE AS score
MATCH (d)-[:MENTIONS]->(e:Entity)
RETURN d.id AS doc_id, score, COLLECT(DISTINCT e.name) AS entidades
ORDER BY score DESC
LIMIT 5
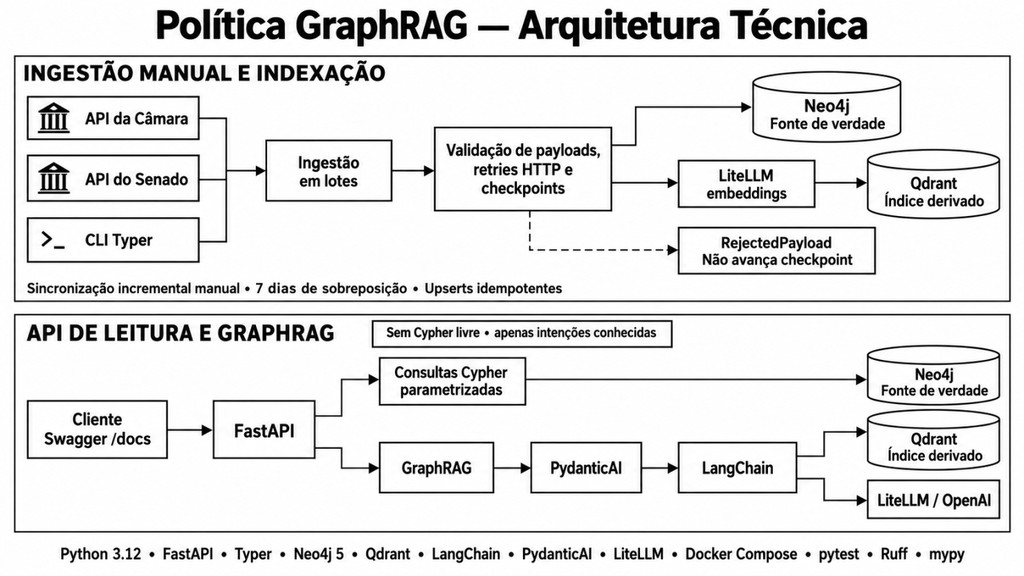
Projeto prático: GraphRAG com Python, LangChain, Neo4j e Docker:
Visão Geral do Projeto
Objetivo: Construir um knowledge graph sobre política brasileira (partidos, deputados, senadores, cargos, votações) e implementar GraphRAG para responder perguntas como:
- “Quais deputados do partido X votaram a favor da PEC Y?”
- “Quais senadores têm relação com o estado Z?”
- “Quais partidos formam a base do governo?”
Dataset: Dados abertos da Câmara e Senado:
Github do projeto: https://github.com/AirtonLira/graphRAG_neo4j_datacamp
#fastapi #neo4j #GraphRAG #langchain #qdrant